API d’extraction d’articles
URL d’un article en entrée, texte structuré propre en sortie — titre, nombre de mots et contenu principal, sans menus de navigation ni bannières cookies.
Capacités
- Supprime automatiquement navigation, publicités, bannières cookies et éléments répétitifs.
- Renvoie le titre, le nombre de mots et le contenu principal en texte ou Markdown.
- Fonctionne sur tout article public, article de blog ou page de documentation.
- Un seul appel, JSON structuré — aucun scraper ni navigateur headless à maintenir.
Pour qui
- Alimenter un pipeline LLM ou un résumeur avec du texte d’article propre.
- Construire une appli « lire plus tard » ou un lecteur RSS personnalisé.
- Indexer du contenu externe pour la recherche sans transporter le bruit HTML.
Ce que vous obtenez
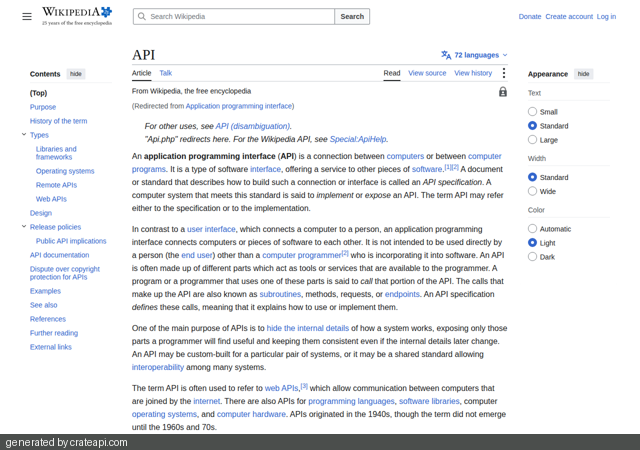
Essayer en direct
Pages publiques uniquement · URL personnalisées : 5 extractions/jour par visiteur · rien n'est conservé
Vous le faites régulièrement ? La même opération devient un seul appel API — au lancement →
Appelez-la depuis votre code
curl -X GET "https://api.crateapi.com/extract/article?url=https://example.com/post" \
  -H "X-API-Key: YOUR_KEY"
La clé API Document Tools s’ouvre au lancement — essayez chaque opération dans la démo en direct ci-dessus, gratuitement, dès maintenant.
Confiance et données
Tarifs
FAQ
Ça marche sur n’importe quel site ?
En général oui sur les articles publics et articles de blog — les pages très scriptées ou payantes peuvent varier.
Texte ou Markdown ?
Les deux sont disponibles — choisissez le format qui convient à votre pipeline.
La page est-elle conservée ?
Non — elle est récupérée, analysée puis renvoyée ; rien n’est conservé ensuite.